(有片)記者直擊|港產機械人 攻克長程任務
【點新聞報道】具身智能發展迅速,但服務機械人的技能往往持續時間只有數秒,長程複雜工作仍有待突破。今年5月成立的全港首個全端具身智能實驗室,正是本港攻克長程任務的先行者。實驗室坐落科學園,已於今年8月啟用,大公報記者率先目睹實驗室「真容」,見到內裏設有足球機械人、VLA雙臂操作機械人及操作台等,充滿高科技元素。
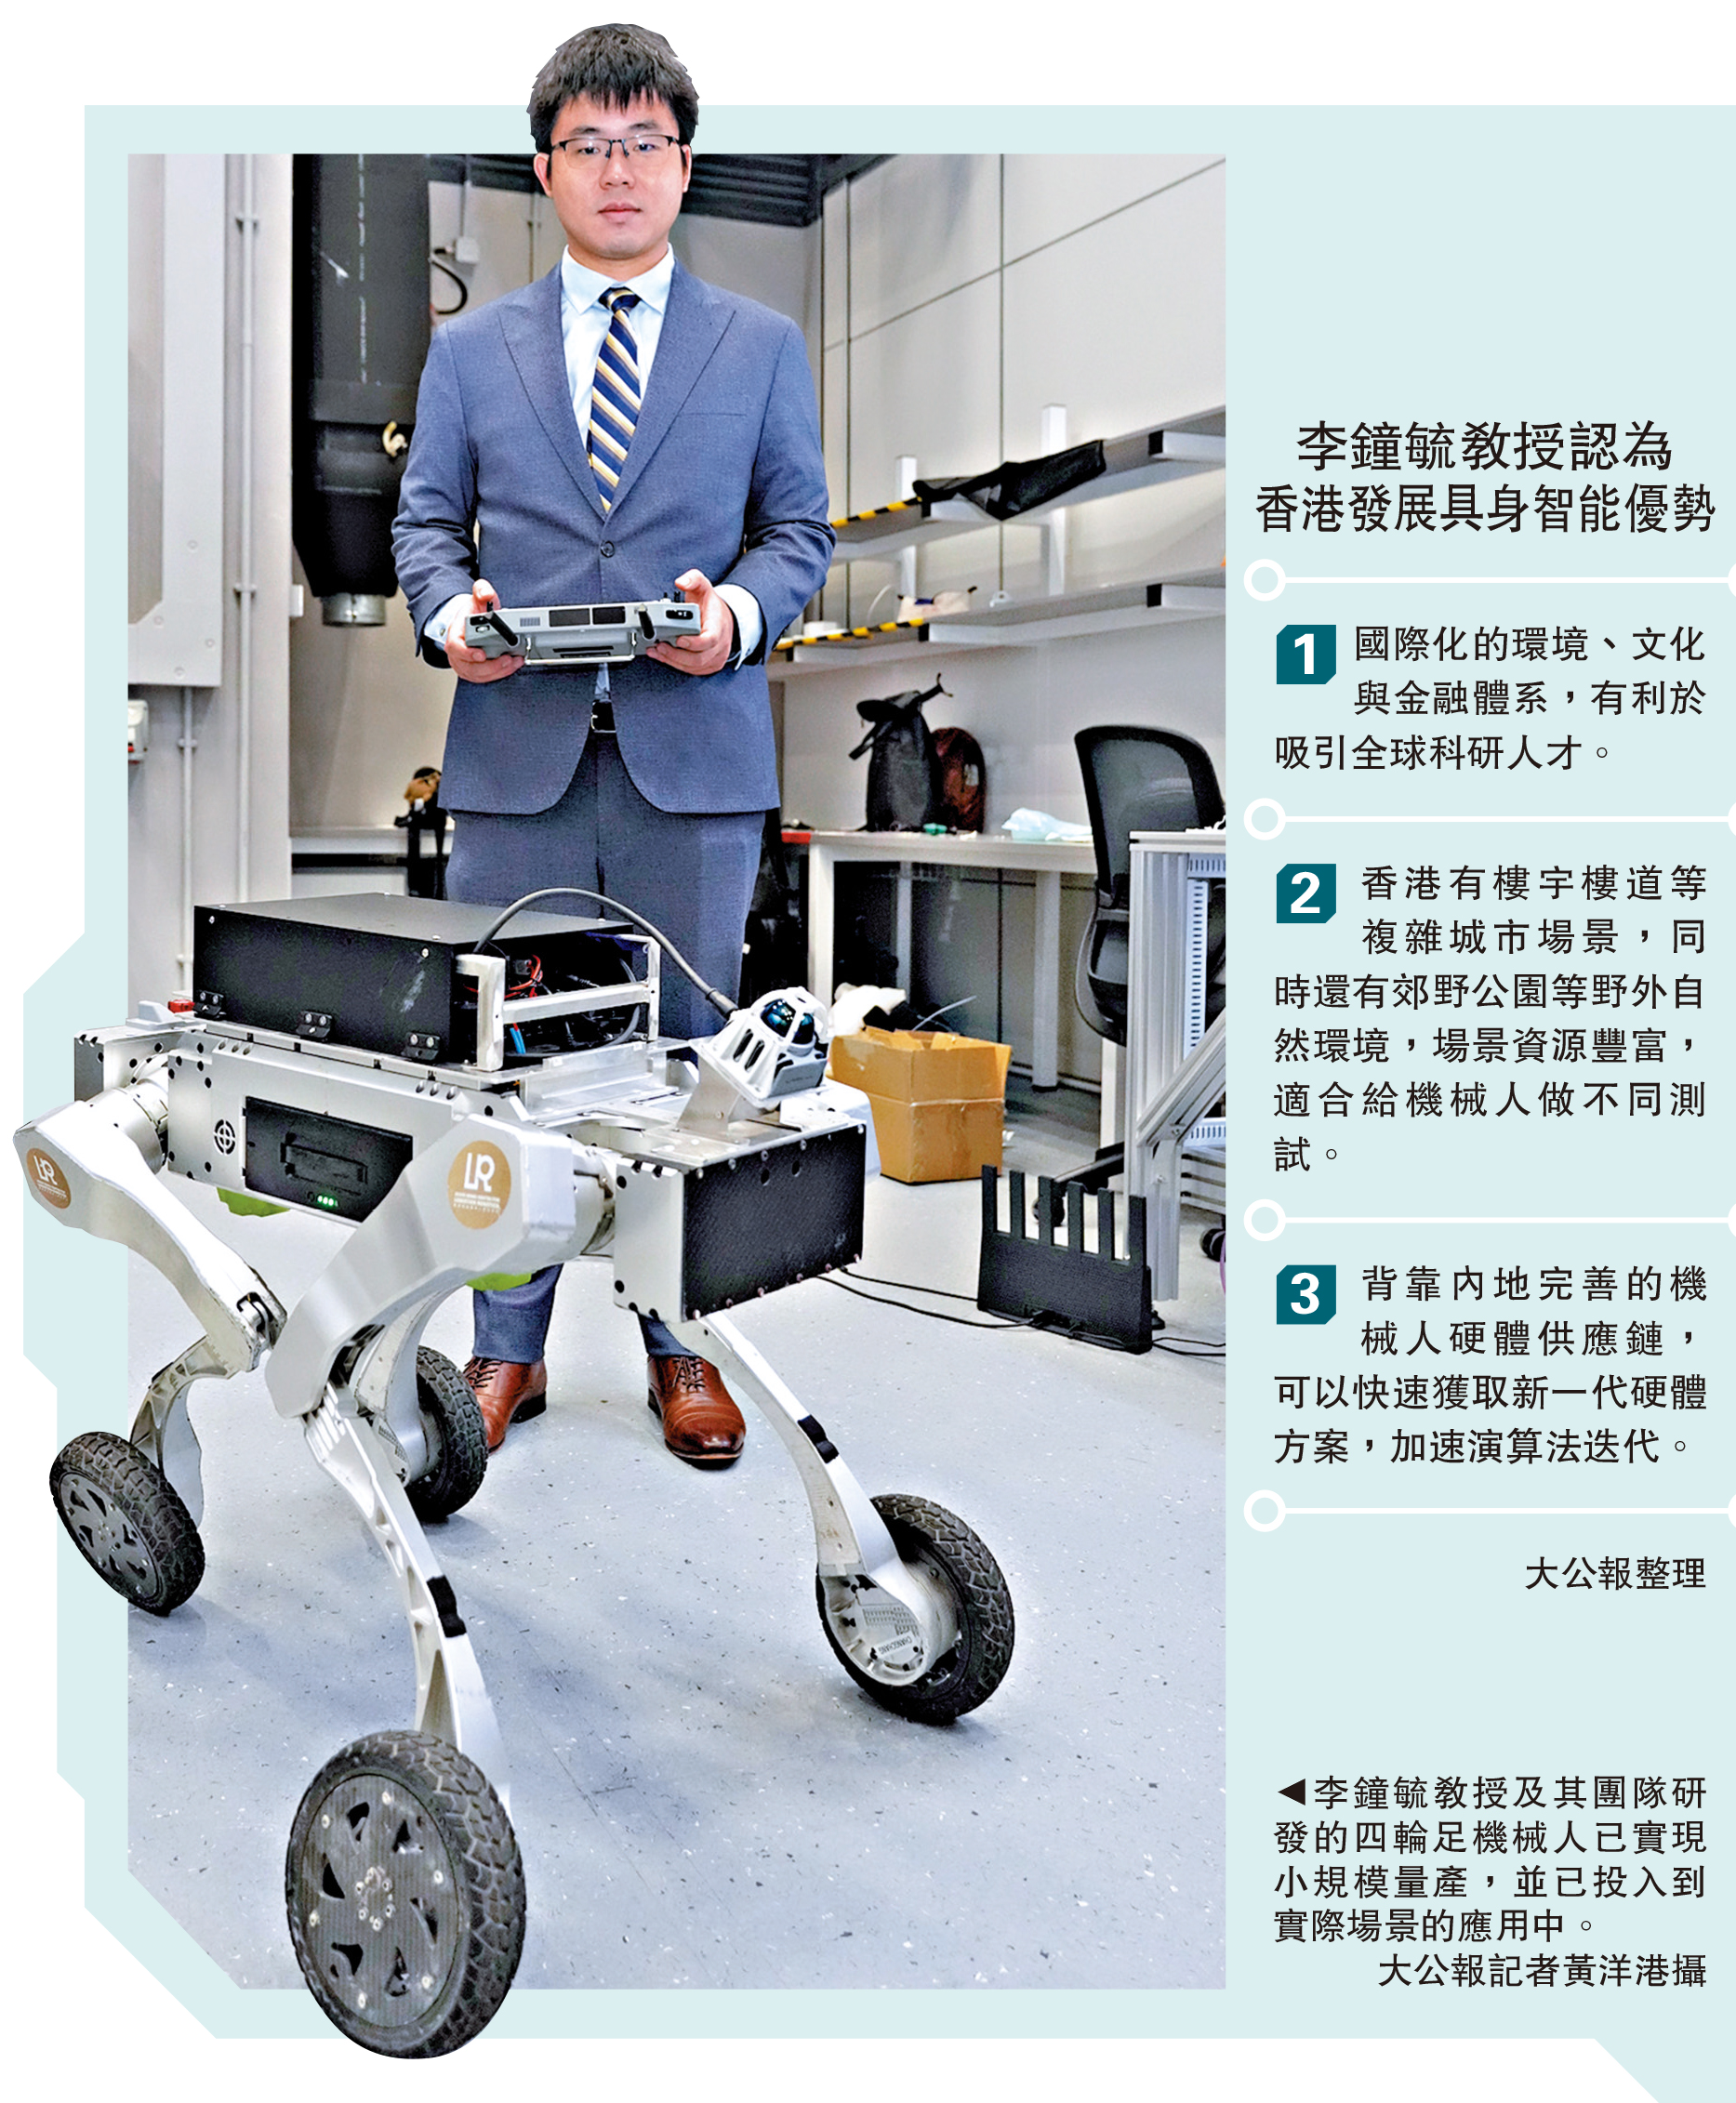
香港中文大學香港具身智能實驗室聯合總監李鐘毓接受《大公報》專訪表示,實驗室今年首次以一套視覺語言動作模型(VLA)機械人完成長達兩分鐘的複雜任務─製作三文治,他指團隊將繼續攻堅更長程任務。實驗室亦有踢足球、打羽毛球等機械人研究,有望日後作陪練等用途,賦能體育發展。
香港具身智能實驗室由香港中文大學InnoHK香港物流機械人研究中心於今年5月宣布成立,與其他具身智能實驗室不同的是,該實驗室定位為首個全端實驗室。
「全端的意思,就是說幾乎具身智能涉及到的整個技術棧我們都有研究。」李鐘毓介紹,這些技術棧大致可以分為五類:第一是硬件設計,即機械人本體的設計,相當於機械人的「血肉」;第二是運動能力,包括平衡控制、步態規劃、阻抗控制與軌跡追蹤等,相當於機械人的「小腦」;第三是環境交互感知能力,體現在各部位完成複雜、精細化的操作任務,相當於機械人的「大腦」;第四和五分別是集群智能中的多機智能以及人機交互智能。
賦予雙臂操作機械人「大腦」
大公報記者於今年8月底率先走進剛落成的全端具身智能實驗室,實驗室位於科學園19W大樓,一進門便見到約1.2米高的足球網狀球門,球門對面則是兩個約一米高的人型足球機械人,通體銀白;再往入面行見到一個門框,供搭載機械臂的機械狗進行開關門等任務訓練,其對面則是VLA雙臂操作機械人及其操作台。
其中,VLA雙臂操作機械人能完成長程任務,亦是機械人「大腦」研究的成果體現。該機械人為兩條手臂狀物體,工作人員在遙控器上下達做三文治的指令後,兩條手臂開始一手夾起一塊麵包放進餐碟上,另一隻手夾起蔬菜疊上,再用另一隻手將最後一塊麵包片疊上,整個過程流暢順利。
「VLA雙臂操作機械人的最大亮點,是依靠同一套控制策略、同一個『大腦』去完成長程任務。」李鐘毓介紹,團隊是在開源基座大模型的基礎上做微調優化,使本身不具備長程任務處理能力的機械人,能夠掌握長程複雜操作。「我們的思路是將大任務拆解成多個子任務。例如製作三文治,子任務分別是:先夾麵包放到盤子;再把菜放到麵包上;再蓋上另一片麵包。」
李鐘毓團隊借鑒的是人類決策學習邏輯。他指,人類會記住過往關鍵事件,即示教軌跡出現速度突變,如機械人快速移動到某位置後緩慢停下。人類示教時到關鍵步驟會下意識放慢,機械人便識別這是重要時間片段,重點關注該段操作,快速移動過程則不必過度關注。實際運行時,機械人檢測關鍵事件發生並保存資訊,整理歷史資訊,完成多子任務組成的長程操作。
「專家示教」助學習新技能
「單純死記硬背無法有效學習,我們團隊首創引入關鍵事件機制,讓機器人只重點記住關鍵事件。」李鐘毓續介紹,這些關鍵事件的學習靠的是「專家示教」(Expert Demonstration)的學習模式,「不需要編寫程式。整個機械人系統分為主臂和從臂,人搖動主臂,從臂跟隨主臂運動,以此完成對機械人的示教。然後機械人演示教學成果時,就用兩個從臂完成。」
「專家示教」原理與人類學習新技能類似,如父母教孩子炒菜,孩子看多便學會。李鐘毓表示,訓練機械人的學習模式有三種,除「專家示教」,還有「獎懲機制」(Reward Function)和「世界模型」(World Models)學習模式。
「我們不是第一個研究長程任務的,但算是目前效果最好的。」李鐘毓表示,以往學界處理兩分鐘的長任務,機械人往往在前一兩個子任務就失敗,而今次香港具身智能實驗室的系統可以連貫地完成整套任務,途中無需額外調試。
至於下一步研究計劃,李鐘毓則希望一方面實現更長程的任務、提升任務成功率;另一方面,目前機械人只能在桌面靜態環境工作,團隊希望把這套能力遷移到人形機械人,讓機械人可以在不同地點完成任務。
運動控制|機械人踢波打羽毛球 未來可當陪練
走進香港中文大學香港具身智能實驗室,大公報記者見到小型網狀球門,兩個身高約一米、白色的機械人在開機後立馬「復活」,起身走到球門線兩側面對面站着,擔當「射門人」和「守門員」的角色。據實驗室聯合總監李鐘毓介紹,這個項目旨在攻克機械人系統中的「小腦」課題─運動控制。
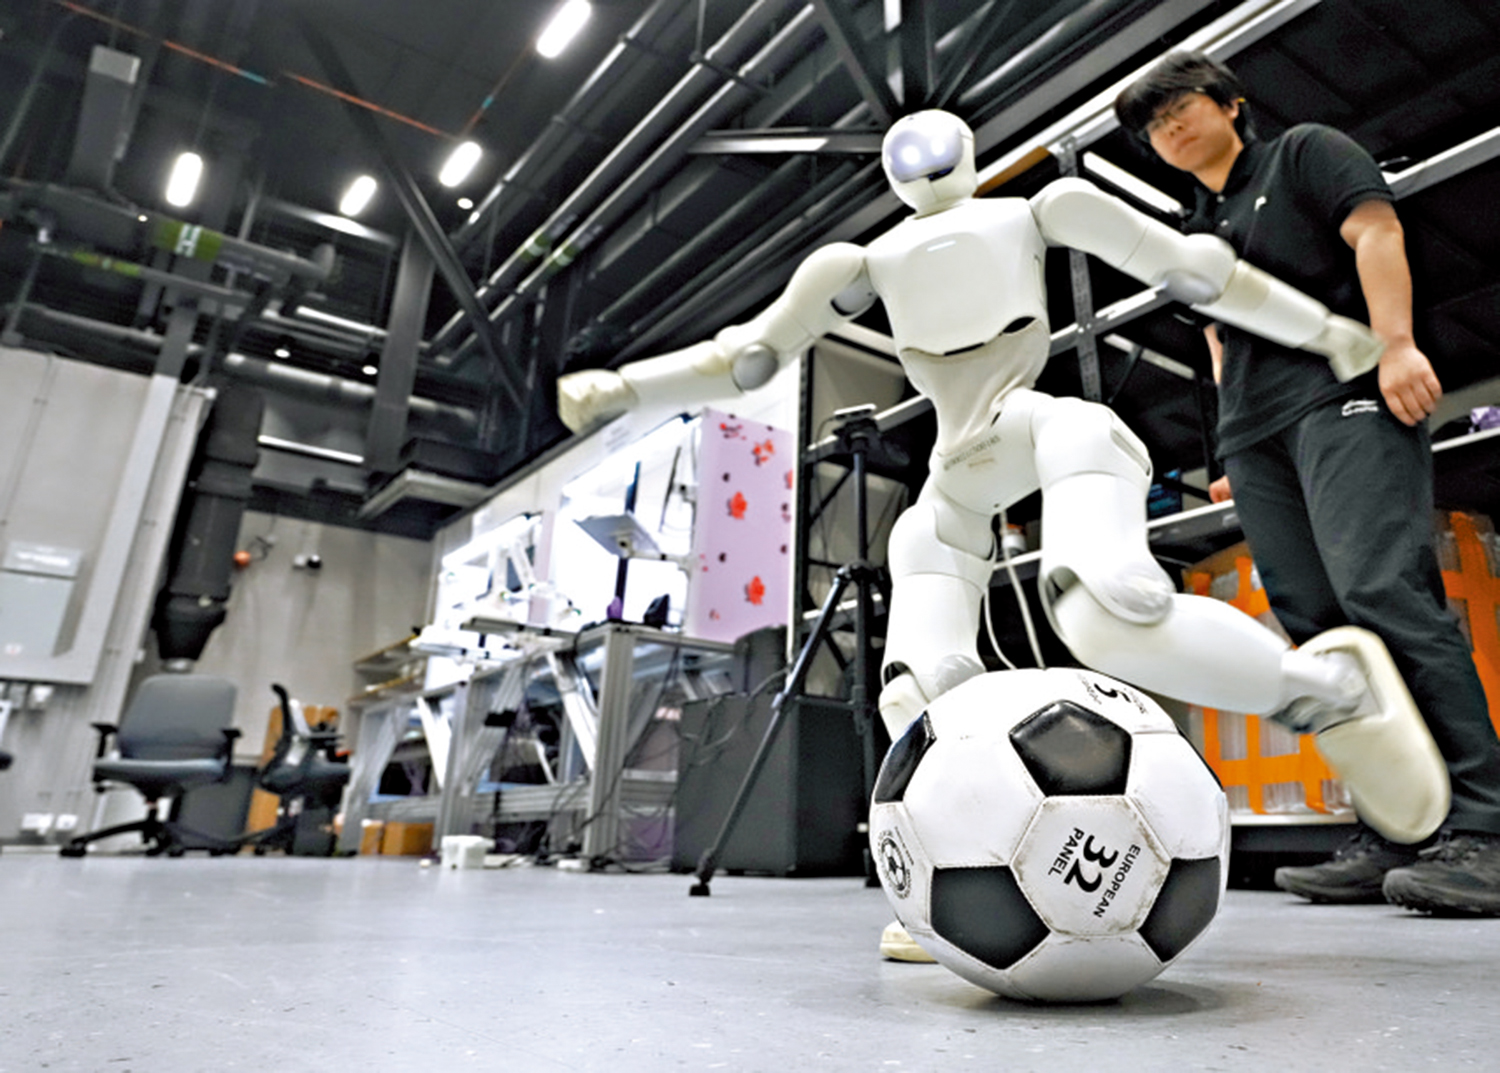
李鐘毓表示,機械人需要在承受衝擊的同時保持平衡,完成射門整套動作,全部動作在短短數秒內完成,需要即時做出決策,輸出最優解決方案。他強調,足球人形機械人的研究重心在於運動控制,未來的落地場景包括陪練。「我們實驗室還有羽毛球機械人,可以完成正手、反手、跳躍扣殺等動作。這項技術屬於全球首創,統計數據顯示人類和它對打時更容易丟球。」
引入獎懲機制 不斷試錯
李鐘毓介紹,研究人員設定目標與規則,讓機械人在大量試錯中自行「摸索」出最有效的射門動作。做得好的動作會獲得「獎勵」,偏離目標的則受到「懲罰」,經過反覆迭代,機械人逐漸形成穩定而精準的踢球策略。
李鐘毓表示,長遠而言,團隊的目標不止於機械人射門。「未來我們希望實現11台機械人的完整足球賽事。足球是研究集群對抗、協作智能的很好的課題。」
具身智能的學習模式,除專家示教與獎懲機制,還有「世界模型」。李鐘毓介紹,這類似人類累積經驗後「在腦中先想一想」:機械人預測不同動作發生後世界會變成怎樣,對比多種結果,選出最優決策。世界模型像人工智能的「內部模擬器」。傳統機械人像「條件反射」,看到紅色就停,感到阻力就退;世界模型讓機械人行動前先「腦補」未來,預判自身行為如何改變環境。
(來源:大公報;視頻來源:大公視頻)